
上下文窗口详解
什么是上下文窗口
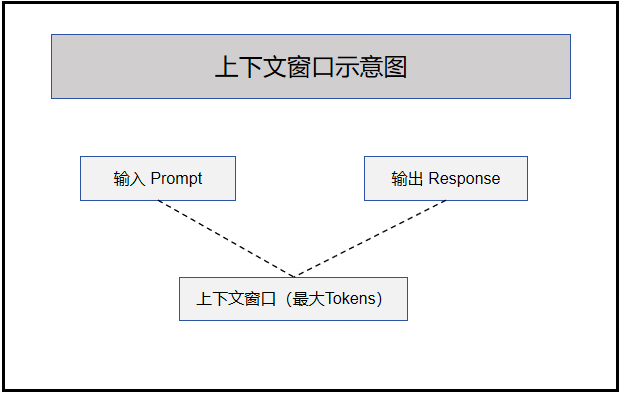
上下文窗口是指模型在单次请求中能处理的最大 token 数量,包括输入(Prompt)和输出(Response)。
seed 系列模型上下文窗口
| 模型 ID | 能力支持 | 长度限制(token) | 限流说明 |
|---|---|---|---|
| deepseek-v4-pro-ga-260813 | 深度思考、文本生成、工具调用、结构化输出 | 上下文窗口: 1024k 最大输入: 1024k 最大回答(默认 4k): 384k 最大思维链: 128k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| deepseek-v4-flash-ga-260731 | 深度思考、文本生成、工具调用、结构化输出 | 上下文窗口: 1024k 最大输入: 1024k 最大回答(默认 4k): 384k 最大思维链: 128k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| deepseek-v4-1-flash-260910 | 深度思考、文本生成、多模态理解、工具调用、结构化输出 | 上下文窗口: 1024k 最大输入: 1024k 最大回答(默认 4k): 384k 最大思维链: 384k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| glm-5-2-260617 | 深度思考、文本生成、工具调用 | 上下文窗口: 1024k 最大输入: 1024k 最大回答(默认 4k): 128k 最大思维链: 128k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| doubao-seed-character-251128 | 文本生成、工具调用 | 上下文窗口: 128k 最大输入: 96k 最大回答(默认 4k): 32k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| doubao-seed-evolving | 深度思考、文本生成、多模态理解、GUI 任务处理、工具调用、结构化输出 | 上下文窗口: 1024k 最大输入: 1024k 最大回答(默认 4k): 256k 最大思维链: 256k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| doubao-seed-2-1-pro-260628 | 深度思考、文本生成、多模态理解、GUI 任务处理、工具调用、结构化输出(推荐使用 json_schema 模式) | 上下文窗口: 256k 最大输入: 256k 最大回答(默认 4k): 256k 最大思维链: 256k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| doubao-seed-2-1-lite-260915 | 深度思考、文本生成、多模态理解、工具调用、结构化输出 | 上下文窗口: 1024k 最大输入: 1024k 最大回答(默认 4k): 256k 最大思维链: 256k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| doubao-seed-2-1-pro-260915 | 深度思考、文本生成、多模态理解、GUI 任务处理、工具调用、结构化输出 | 上下文窗口: 1024k 最大输入: 1024k 最大回答(默认 4k): 256k 最大思维链: 256k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| glm-5-3-flash-260826 | 深度思考、文本生成、多模态理解、工具调用 | 上下文窗口: 1024k 最大输入: 1024k 最大回答(默认 4k): 128k 最大思维链: 128k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| glm-5-3-260814 | 深度思考(强制)、文本生成、工具调用、结构化输出、流式工具参数 | 上下文窗口:1024k(1M) 最大输入:1024k 最大回答: 128k 最大思维链: 128k(内置于上下文中) | 最大 RPM: 500(标准版) 最大 TPM: 1,000,000 说明: 始终开启思考模式,不可关闭:支持 tool stream=true 实现工具参数的流式返回。 |
| kimi-k3-260716 | 深度思考、文本生成、工具调用、原生多模态视觉理解、流式输出stream、JSON 结构化输出 | 上下文窗口: 1024k 最大输入: 1024k 最大回答(默认 4k): 128k 最大思维链: 128k | 最大 RPM: 500 最大 TPM: 1000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| doubao-seed-2-0-pro-260215 | 深度思考、文本生成、多模态理解、GUI 任务处理、工具调用、结构化输出 | 上下文窗口: 256k 最大输入: 224k 最大回答(默认 4k): 128k 最大思维链: 128k | 最大 RPM: 30000 最大 TPM: 5000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| doubao-seed-2-0-lite-260215 | 深度思考、文本生成、多模态理解、GUI 任务处理、工具调用、结构化输出 | 上下文窗口: 256k 最大输入: 224k 最大回答(默认 4k): 128k 最大思维链: 128k | 最大 RPM: 30000 最大 TPM: 5000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| doubao-seed-2-0-mini-260215 | 深度思考、文本生成、多模态理解、GUI 任务处理、工具调用、结构化输出 | 上下文窗口: 256k 最大输入: 224k 最大回答(默认 4k): 128k 最大思维链: 128k | 最大 RPM: 30000 最大 TPM: 5000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
| seed-2-0-code-preview-260215 | 深度思考、文本生成、多模态理解、工具调用 | 上下文窗口: 256k 最大输入: 256k 最大回答(默认 4k): 128k 最大思维链: 128k | 最大 RPM: 30000 最大 TPM: 5000000 非刚性保障,受平台负载/调用方式影响,详见文档 |
上下文对模型的影响
1. 输入长度影响可用输出空间
Context window: 4096 tokens

Case A: Simple task
├── Input: 100 tokens
└── Available output: 3996 tokens ✅ Sufficient

Case B: Medium task
├── Input: 3500 tokens
└── Available output: 596 tokens ⚠️ Limited

Case C: Long-text task
├── Input: 4000 tokens
└── Available output: 96 tokens ❌ Almost no output possible
2. 注意力衰减现象
随着序列增长,模型对早期内容的注意力会逐渐减弱:
Input: [user question] [context1] [context2] ... [latest content]
       ↑
     Strong attention                       Weak attention
可能问题:
- 忽略开头的关键指令
- 遗忘中间部分的背景信息
- 错误引用内容来源
3. 长上下文的理论挑战
| 挑战 | 说明 |
|---|---|
| 计算复杂度 | 自注意力计算量与序列长度的平方成正比 |
| 内存占用 | KV Cache 随序列长度线性增长 |
| 通信开销 | 分布式推理时跨节点传输数据量增大 |
应用场景建议
短上下文场景(≤ 32K)
| 场景 | 推荐理由 |
|---|---|
| 客服对话 | 单轮交互,响应简洁 |
| 简单问答 | 任务单一,无需长背景 |
| 文本补全 | 短文本生成任务 |
| 代码生成 | 函数级代码,片段输出 |
中等上下文场景(64K - 128K)
| 场景 | 推荐理由 |
|---|---|
| 文档分析 | 可分析 10-20 页 PDF |
| 多轮对话 | 保留多轮对话历史 |
| 代码调试 | 包含完整文件上下文 |
| 内容创作 | 中长篇文章写作 |
长上下文场景(> 128K)
| 场景 | 推荐理由 |
|---|---|
| 长篇小说 | 可处理整章内容 |
| 代码库理解 | 整个文件的理解分析 |
| 书籍摘要 | 整本书的总结提炼 |
| 知识库问答 | 大量文档检索增强 |
参数配置建议
max_tokens 参数
控制模型最大输出 token 数:
python
response = client.chat.completions.create(
    model="gpt-4o",
    messages=[
        {"role": "user", "content": "Explain quantum computing in detail"}
    ],
    max_tokens=2000
)
场景化配置
| 场景 | 建议 max_tokens | 说明 |
|---|---|---|
| 简短问答 | 300-500 | 简洁回答 |
| 标准问答 | 1000-2000 | 完整回答 |
| 详细解释 | 3000-4000 | 深入分析 |
| 长文写作 | 5000-8000 | 文章输出 |
设置建议
Suggested formula:
max_tokens = context window × 0.4 ~ 0.5

Example (128K window):
max_tokens ≈ 50000 ~ 64000

Note: Reserve space for input; recommended not to exceed 50% of the window.
超限处理策略
1. 分段处理 (Chunking)
适用于长文档分析、书籍摘要:
python
def process_long_document(text, chunk_size=4000, overlap=200):
    chunks = []
    tokens = text.split()

    for i in range(0, len(tokens), chunk_size - overlap):
        chunk = ' '.join(tokens[i:i + chunk_size])
        chunks.append(chunk)

    return chunks
2. 摘要压缩
适用于多轮对话历史过长:
python
def summarize_conversation(messages, max_tokens=4000):
    summary_prompt = f"""Summarize the following conversation as key points, keeping it within {max_tokens} tokens:
{messages}
Summary:"""

    summary = call_llm(summary_prompt)
    return [
        {"role": "system", "content": "Summary of previous conversation: " + summary},
        messages[-1]
    ]
3. 检索增强 (RAG)
适用于需要处理海量知识的场景:
User question ──→ Retrieve ──→ Relevant docs ──→ Build Prompt ──→ LLM inference
                          ↑
                       Keep only the most relevant chunks
最佳实践
1. 重要信息放置
- 关键指令放在开头或结尾
- 使用结构化格式突出关键点
2. 根据任务选模型
| 任务类型 | 推荐模型 | 理由 |
|---|---|---|
| 短对话 | GPT-4o-mini | 快速低成本 |
| 文档分析 | Claude 3.5 | 长上下文支持 |
| 超长任务 | Gemini 3 Pro | 百万级上下文 |
3. 监控与优化
python
def estimate_tokens(text):
    return len(text.split()) * 1.3

def check_context_usage(prompt, max_tokens, context_window):
    estimated = estimate_tokens(prompt)
    available = context_window - max_tokens
    usage_ratio = estimated / available

    if usage_ratio > 0.9:
        return "warning"
    return "ok"
常见问题
Q: 为什么输出被截断?
可能原因:
max_tokens设置过小- 上下文窗口已满
Q: 如何避免"遗忘"问题?
- 将重要信息放在输入开头或结尾
- 使用结构化格式突出关键点
- 超长任务使用分段处理
Q: 上下文窗口越大越好?
不一定。更大上下文带来更高延迟和成本,过长上下文可能导致中间部分注意力减弱。建议根据实际任务选择合适的模型。